Dataverzameling
Veld- en fysieke-werelddata
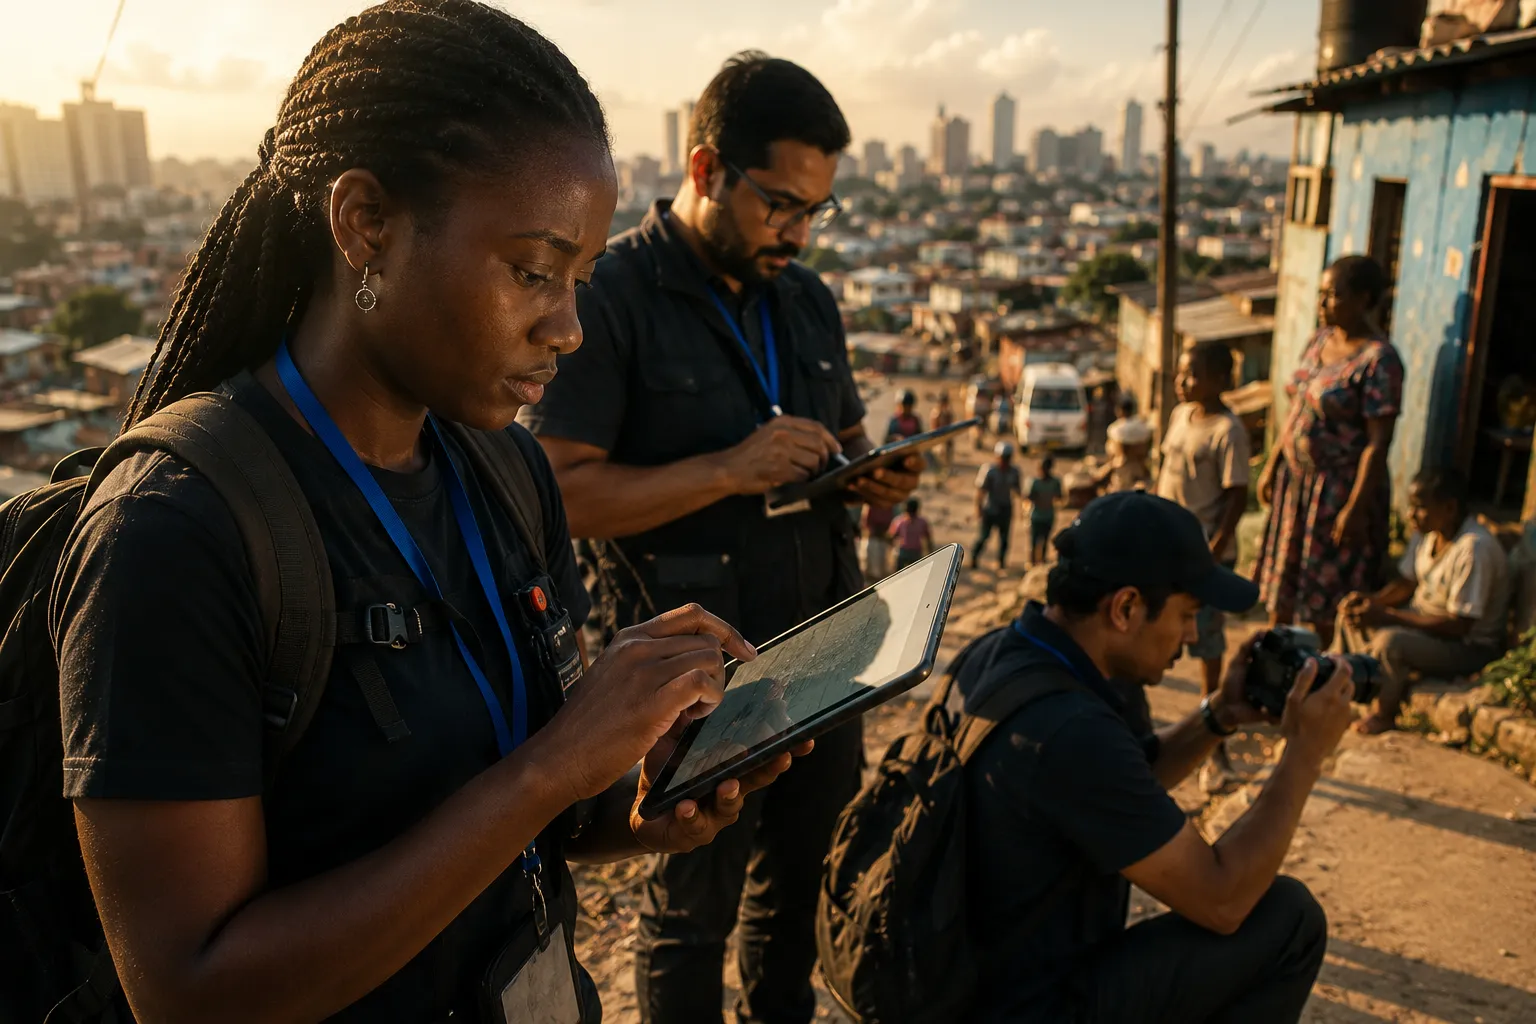
Veld-, web-, audio-, video- en sensordataverzameling geleverd door teams die leven waar de data wordt verzameld.
Meer informatieVeldgegevensverzameling, annotatie, RLHF, spraak- en roboticatrainingsgegevens, geleverd door meer dan 15.000 mensen in meer dan 18 landen en meer dan 35 talen. Wij bezitten de infrastructuur en nemen volledige SLA-verantwoordelijkheid van verzameling tot levering.
Verzameling, annotatie, RLHF, spraak, robotica en red-teaming, gescoord, bemand en geleverd onder één SLA.
Start een pilot Voor talent wereldwijdVerdien geld door AI te leren wat alleen mensen weten. Op locatie, op afstand, contract, vast en flexibel werk in meer dan 18 landen.
Bekijk vacaturesZeven diensten, één verantwoordelijke operator, van het veld waar data wordt verzameld tot de batch die naar uw modellen wordt verzonden.
Veld- en fysieke-werelddata
Veld-, web-, audio-, video- en sensordataverzameling geleverd door teams die leven waar de data wordt verzameld.
Meer informatieElke modaliteit, 97%+ nauwkeurigheid
Beeld-, video-, LiDAR-, tekst-, audio- en multimodale annotatie met 97%+ nauwkeurigheid via een drietraps-QA-cascade.
Meer informatieLLM-uitlijning op schaal
Reinforcement learning van menselijke feedback, voorkeurslabeling, SFT-demonstraties en beloningsmodellering.
Meer informatieTTS/ASR in zeldzame talen
TTS-datasets, ASR-trainingsdata en transcriptie in meer dan 35 talen, waaronder zeldzame en laagbronnen-talen.
Meer informatieRealistische sensor- en visiedata
Teloperatie, manipulatie en realistische sensor-/visiedata voor consumenten- en industriële robotica.
Meer informatieAI-veiligheid en modelevaluatie
Adversarieel testen, jailbreak-ontdekking, hallucinatiedetectie en modelevaluatie voor AI-veiligheid.
Meer informatieStrategie, analyse en levering
AI-datastrategie, datasetontwerp, annotatietaxonomie, evaluatieontwerp en advies over leveringsoperaties.
Meer informatieKies wat u traint en wij laten u de delen van de pijplijn zien die gewoonlijk het meeste tellen, en nemen u vervolgens mee naar het volledige AI-dataoverzicht.
Image, video, and LiDAR annotation plus field capture, held consistent across millions of frames.
Corpshore bezit fysieke infrastructuur, zet ingebedde lokale teams in en tekent één SLA voor de gehele pijplijn.
Eén verantwoordelijke eigenaar van verzameling tot levering, geen marktplaats die u een dashboard geeft en verdwijnt.
Eigen fysieke infrastructuur en ingebedde teams verzamelen echte data die platforms alleen kunnen afwachten.
Fulltime medewerkers in de regio, geen anonieme crowdwerkers, getraind, behouden en verantwoordelijk voor uw taxonomie.
Annotators wonen in de gemeenschappen wier talen zij gebruiken. Dat is waarom onze meertalige data stand houdt.
Corpshore draait op Jwuma, ons eigen tweezijdige platform: een klantenportaal dat commerciële voorwaarden in software afdwingt, en een bijdrager-app die mensen wekelijks betaalt op basis van door mensen beoordeelde QA-acceptatie.
Corpshore recruits, vets, trains, manages, and pays the people behind your training data. You submit a spec and review the work; the platform runs everything else, with commercial terms enforced in software.
Review clocks, cure windows, prepaid balances, and country restrictions enforced by the platform, not a PDF.
The standard is frozen when a batch begins, taught in onboarding, and applied by internal QA on every submission.
Contributor PII sits in its own regional database, never pooled into one global store by default.
Every change writes an audit row; bulk exports require two-administrator approval.
Eigen hubs in Centraal-Azië, Zuidoost-Azië, Afrika, MENA en Latijns-Amerika. Verken capaciteit, talen en naleving per hub.
Uzbek · Russian · Karakalpak · Tajik
Speech & TTS · Rare-language annotation · RLHF
GDPR-aligned DPA
Onze meertalige capaciteit komt van annotators die in de gemeenschappen wonen wier talen zij gebruiken, niet van een Engelse vertaaloverlay.
Kenya · Tanzania · Uganda
TTS/ASR datasets reduced WER from 11.2% to 4.3%.
Elke werkeenheid doorloopt een drietraps-QA-cascade voordat deze wordt verzonden. Elke laag vangt op wat de vorige heeft gemist.
Trained in-region annotators label to a versioned taxonomy. Every unit gets a structured peer check before it moves.
Domain QA leads audit sampled and flagged work, resolve edge cases, and feed corrections back into annotator guidance.
Automated consistency checks, gold-set benchmarking, and consensus scoring gate the batch before delivery.
Geleverd werk, beschreven met echte cijfers. Klantnamen zijn vertrouwelijk; de resultaten zijn niet verzonnen.
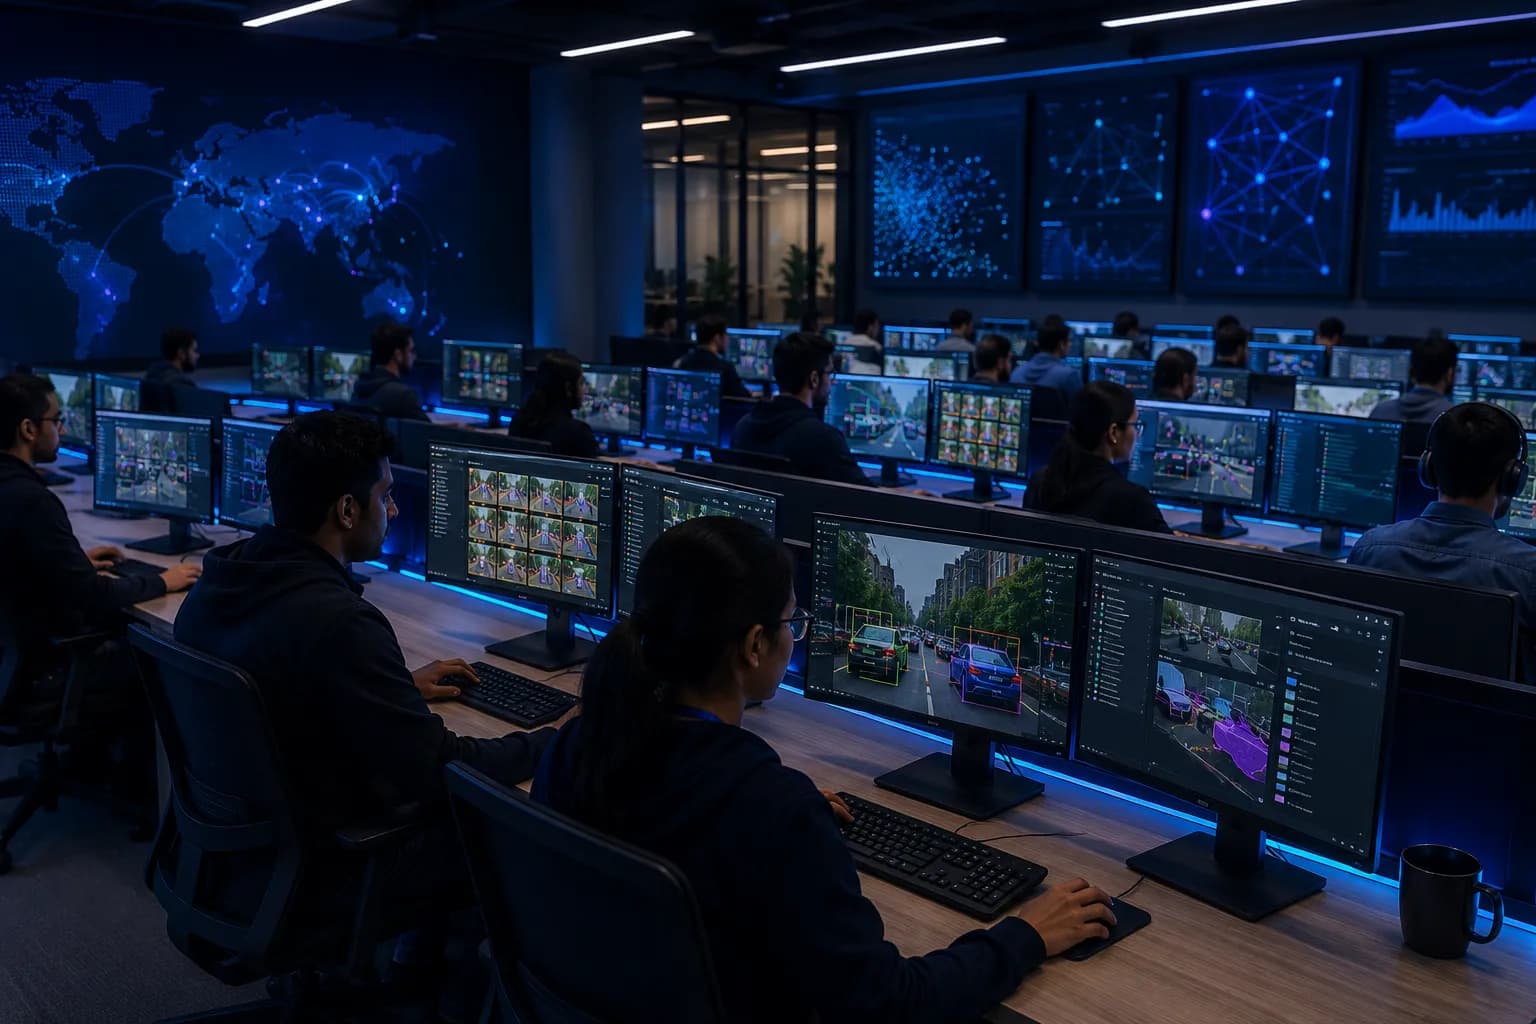
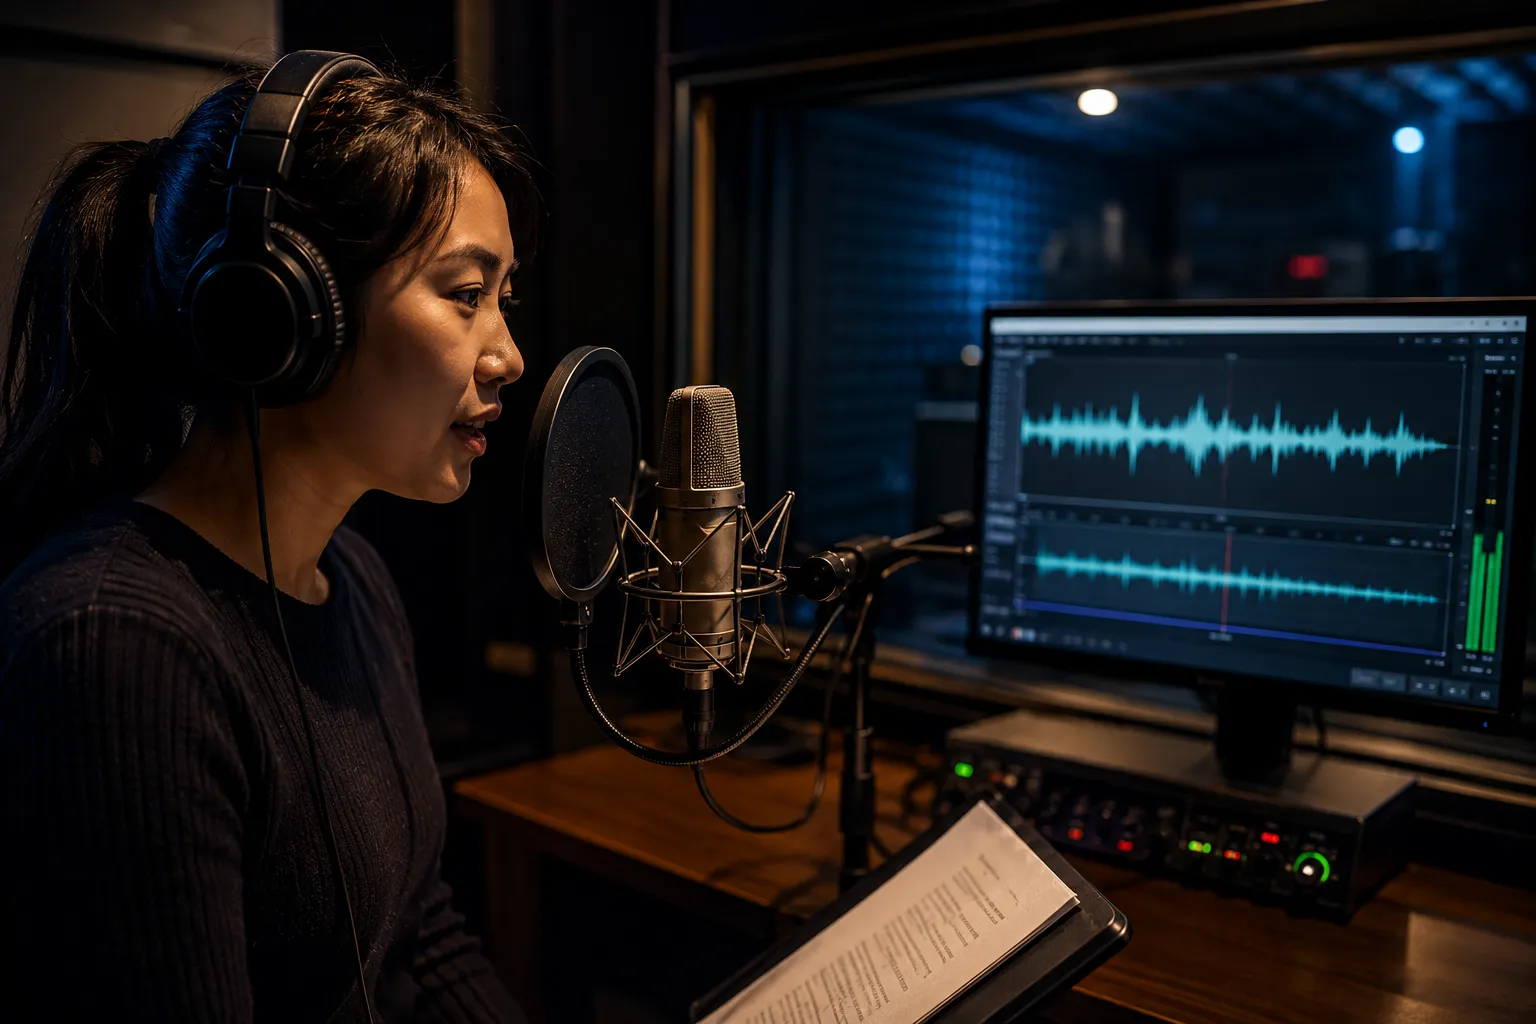
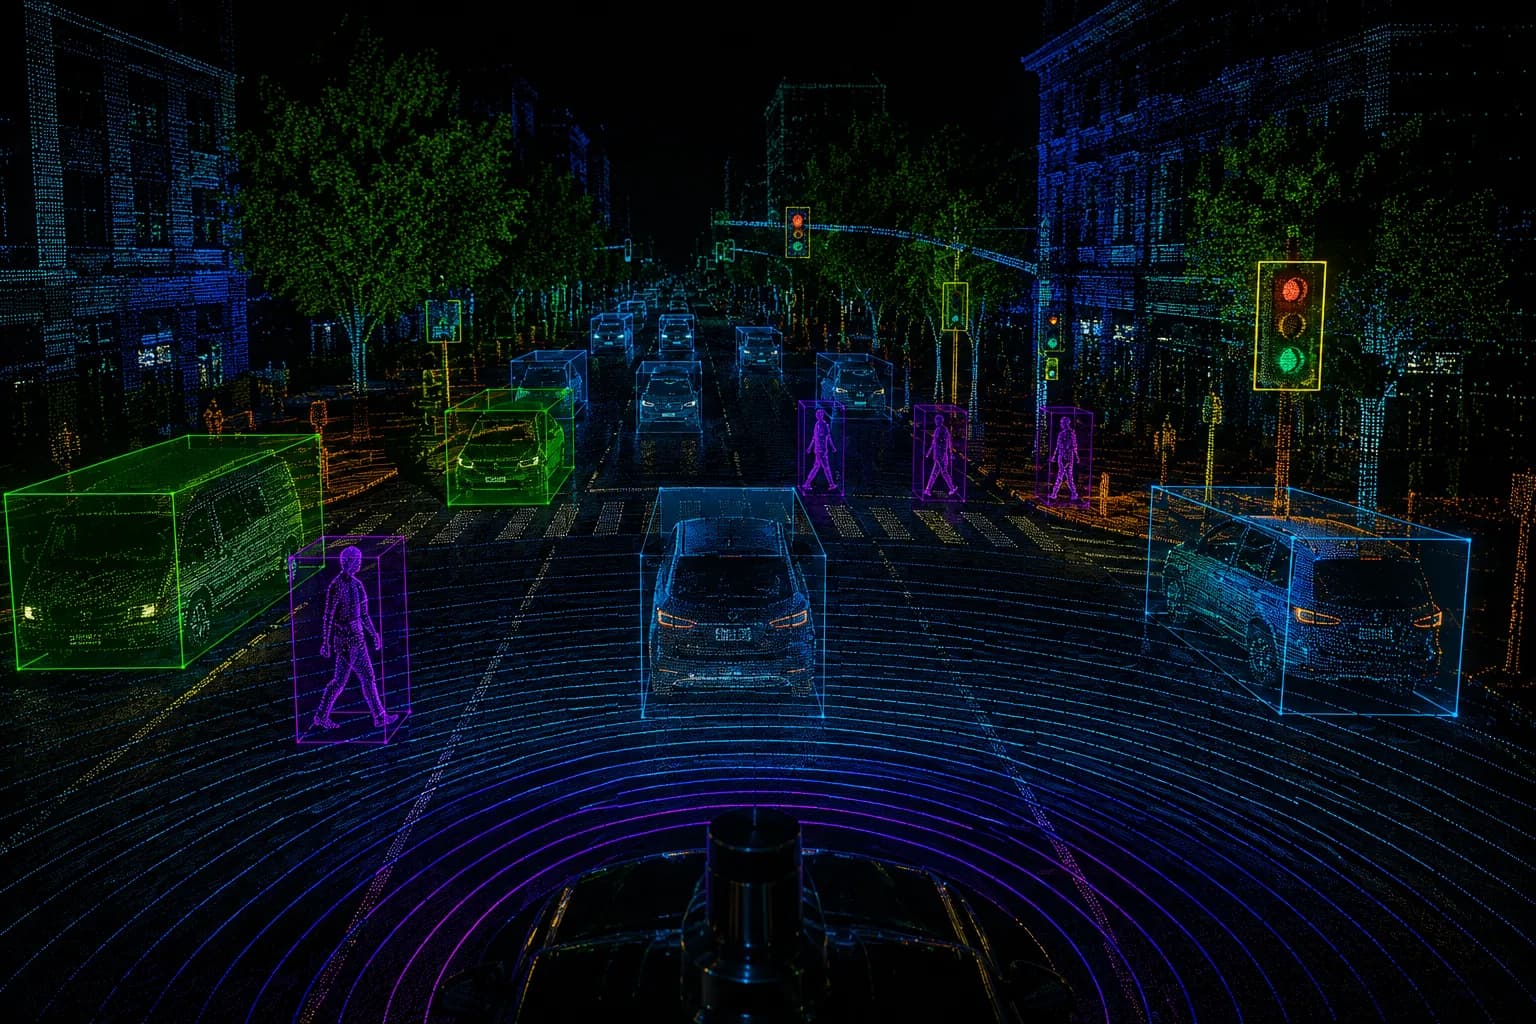
Indicative only, reflects a 50 to 70% cost advantage vs US-domestic providers. Actual scope, taxonomy, and QA depth are set during pilot scoping.
Scope this pilot with usCorpshore draait op echte werkgelegenheid en eerlijk loon in de gemeenschappen waar wij actief zijn. Het is de juiste manier om AI-data te bouwen, een claim die onze concurrenten niet geloofwaardig kunnen maken.
Bedrijfsmatige beveiliging, dataresidentie per hub en auditklare herkomst.
Bezoek het VertrouwenscentrumCorpshore AI is een AI-dataoperatiebedrijf dat door Outsource Accelerator is gerangschikt als #5 onder de beste AI-outsourcingbedrijven ter wereld. Het levert veldgegevensverzameling, annotatie, RLHF, spraakverzamelingen en roboticatrainingsgegevens via meer dan 15.000 werkplekken in meer dan 18 landen en meer dan 35 talen.
Vertel ons uw modaliteit, volume en talen. Wij komen terug met een scope, tijdlijn en kostenbandbreedte.
Start een pilotSluit u aan bij meer dan 15.000 mensen die AI leren wat alleen mensen weten, op locatie, op afstand, contract of flexibel.
Bekijk vacatures